Um ecossistema completo: do código à produção, com o mesmo método

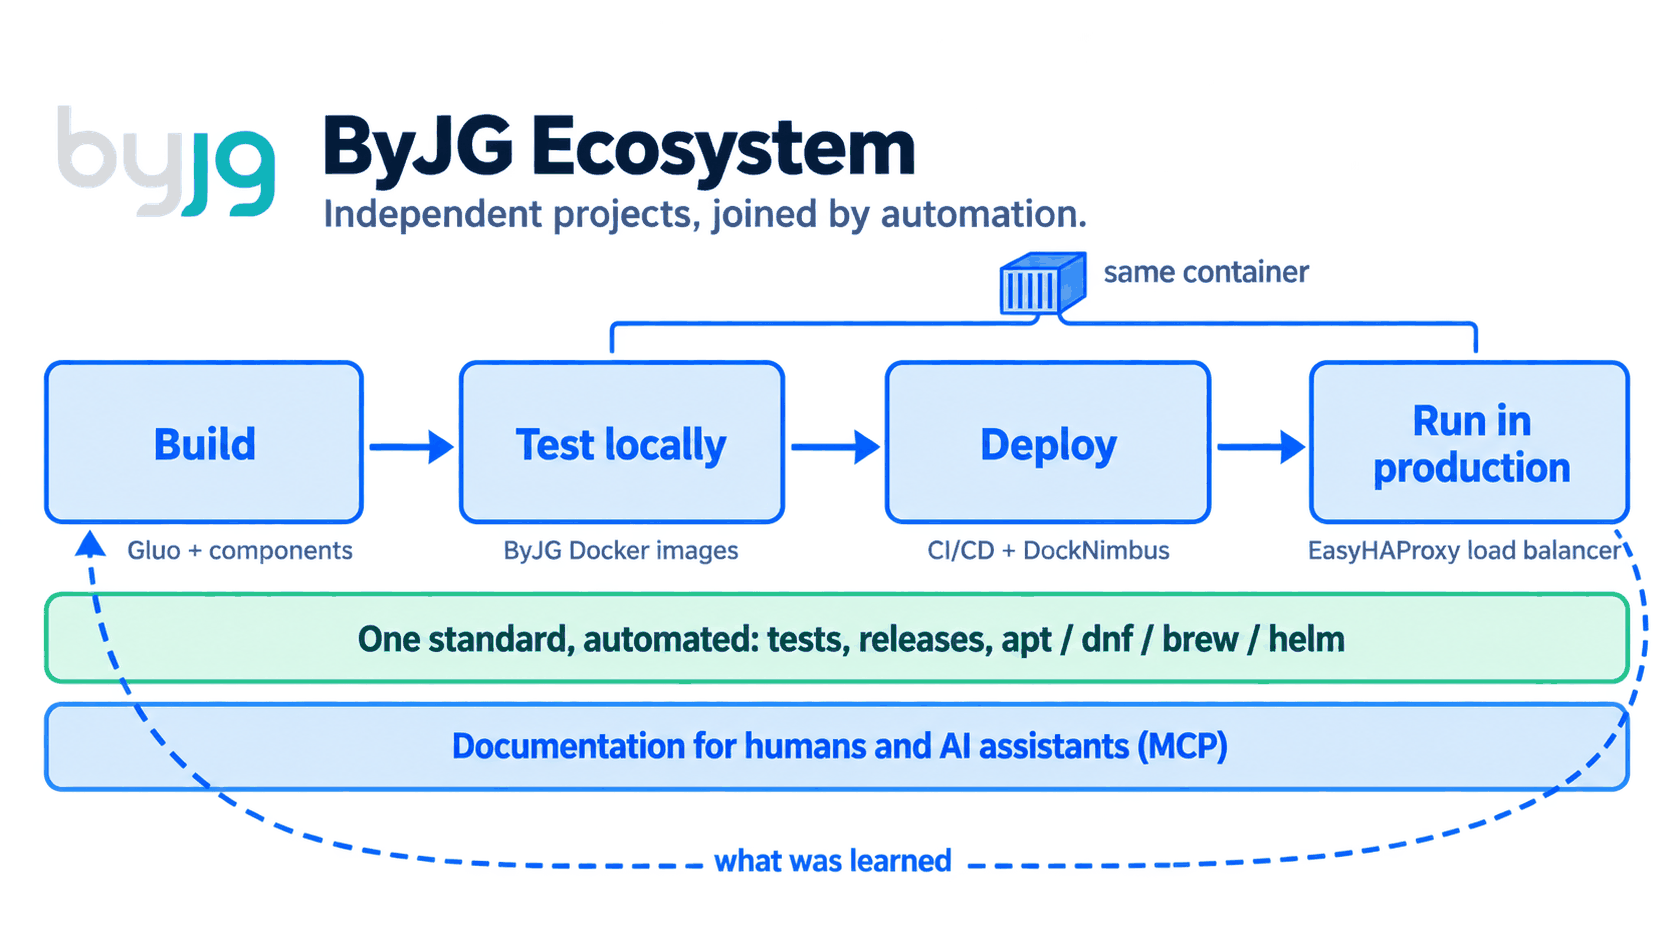
Hoje eu consigo construir uma aplicação, testar na minha máquina, publicar e rodar em produção usando apenas projetos que eu mantenho, e o contêiner que eu testei é o mesmo que vai para produção. Eu nunca planejei um "ecossistema". Ele é o resultado de um método que eu venho repetindo há mais de vinte anos, e este artigo conta de onde esse método veio e como ele funciona hoje.
Tudo começou com um index.asp
Tudo começou no ano 2000, quando eu trabalhava na Unitech, uma empresa de outsourcing para o governo. Eu fazia parte do setor de Pesquisa e Desenvolvimento, e uma das nossas missões era validar se o .NET 1.0 era um bom caminho para migrar de VB 6.0 para Web Forms. A Unitech era parceira da Microsoft, e por isso tínhamos acesso às versões beta muito antes do lançamento. Fizemos a pesquisa, os testes e as provas de conceito, treinamos e acompanhamos algumas equipes.
A grande mudança chegou quando fui alocado no projeto SOMAR (Sistema Organizado de Matrícula). Até então o sistema era 100% VB6 com Oracle 7.3 e stored procedures, mas a licitação daquele ano exigia a entrega de uma versão web, algo bastante novo na época. Eu já havia trabalhado em uma empresa de web design e tinha escrito o meu próprio CGI em Delphi (CGI era o mecanismo em que o servidor web executava um programa a cada requisição e devolvia ao navegador o que esse programa escrevesse), então me colocaram no projeto como Plano B. O Plano A era entregar o VB6, que já estava pronto, e ter uma versão web apenas como entregável, sem a expectativa de que fosse usada.
Escolhemos o ASP 3.0, que saiu no mesmo ano que o PHP 4, quando as duas tecnologias ainda eram muito primitivas: basicamente includes e comandos para escrever texto na página, com um JavaScript também muito limitado. Mesmo sem a pressão da entrega, resolvi criar algo que fosse fácil para o desenvolvedor e que escondesse a complexidade de misturar HTML com código. Eu já tinha trabalhado com ColdFusion e com CGI, e tudo era muito técnico, com uma curva de aprendizado alta.
Pensei em como um projeto em C se organiza, com o seu main.c e os seus headers, e adaptei a ideia para a nossa realidade em ASP 3.0. Cada página tinha os seus "headers" e uma função principal:
<!-- #include file="bancodedados.inc" -->
<!-- #include file="seguranca.inc" -->
<!-- #include file="menu.inc" -->
<!-- #include virtual="design.inc" -->   <% ' desenha o layout e chama a Main %>
<%
Sub Main
    ' o que esta página faz: uma listagem, um cálculo, um download
End Sub
%>
Os includes guardavam o código específico de cada assunto, como conectar ao banco ou verificar se o usuário tinha permissão de acesso, e a Main de cada página executava apenas o que aquela página deveria fazer. Quem chamava a Main era o design.inc: ele desenhava o layout, aquele quadradão com topo, menu e rodapé, e sabia em que ponto dele o resultado da página deveria aparecer. Com essa técnica, e reaproveitando as stored procedures que já existiam, o nosso time de quatro pessoas entregou o sistema web, que acabou sendo o protagonista do projeto e o primeiro sistema web da Unitech. Depois eu aprimorei a técnica e a repliquei em outros projetos da empresa, com um ganho enorme de produtividade.
O XMLNuke e o que ele me ensinou
Ao sair da Unitech resolvi investir no meu "framework". Naquela época o Java difundiu massivamente o uso de XML, que tinha a sua camada de formatação, o XSL. Com os dois eu conseguiria isolar a camada de dados da camada de apresentação. Era uma ideia tentadora, e havia poucas opções na época; na onda dos CMS existiam o PHP-Nuke e o PostNuke.
Criei então o XMLNuke. As classes que você escrevia produziam XML, e uma camada de processamento XSL transformava esse XML em HTML. A primeira versão foi em ASP, continuação natural do que eu tinha feito na Unitech, e o projeto está registrado no SourceForge desde maio de 2002. Em 2003 vieram as versões em Java, C# e PHP, todas com o mesmo jeito de programar. Foi no PHP que eu acabei investindo, porque o ASP era bem mais limitado e porque eu tinha decidido apostar no Linux. A versão de 2003 rodava em PHP 4, depois ficou parada por um bom tempo, e eu só a retomei com o PHP 5, em 2006, que foi a versão que amadureceu. O XMLNuke foi também o meu primeiro código open source: começou em CVS, passou para SVN no SourceForge e, muitos anos depois, foi para o GitHub.
De certa forma o XMLNuke antecipava o que hoje fazemos com APIs REST e JSON, em que o código produz dados e a apresentação fica em outra camada. A diferença é que o JSON é muito mais simples e dispensa um framework para ser lido.
O XMLNuke era um monolito imenso, que precisava de uma estrutura de diretórios específica para rodar. Com ele aprendi que um framework não pode ser monolítico nem engessado, que é mais fácil manter vários componentes pequenos e coesos do que um sistema em que tudo está acoplado, porque nele uma mudança pequena acaba quebrando partes que não tinham nada a ver com ela, e que uma especificação padrão e uma boa documentação são tão importantes quanto o código. Matei o XMLNuke e carreguei as lições.
Essas lições viraram componentes menores. Os componentes me ensinaram a reduzir complexidade e a separar responsabilidades, depois pediram imagens Docker para rodar sempre do mesmo jeito, depois pediram automação para publicar, e assim por diante. Em Como eu consigo manter mais de 30 projetos open source eu contei como isso funcionava quando havia dois pilares, os componentes PHP e as imagens Docker. De lá para cá entraram o DockNimbus, o ByJG Docs MCP, o Parolsh e os repositórios de pacotes, e as peças passaram a cobrir o caminho inteiro.
Construir a aplicação
Depois do XMLNuke eu relutei muito em ter um framework de novo. Mantive apenas componentes separados e completamente independentes. Os primeiros eu extraí do próprio XMLNuke, ainda na época da MaxMilhas, e cada um passou a ter vida própria. Com o tempo percebi que, sempre que eu usava esses componentes, eu seguia a mesma metodologia: um jeito próprio de escrever e de conectar as peças.
Primeiro registrei esse jeito no PHP Rest Reference Architecture, uma arquitetura de referência que definia as guidelines, mas ainda deixava muita coisa solta. Foi com ela que fiz o site do KingPanda (kingpanda.com.br). Este ano, finalmente, transformei a arquitetura de referência em um framework chamado Gluo, que significa "cola" em esperanto, porque é isso que ele faz com os meus componentes.
Um composer create-project byjg/gluo cria um projeto de API REST que é seu, já com autenticação, migrations, ORM, documentação OpenAPI e a estrutura de testes. É a mesma ideia do index.asp de 2000: o desenvolvedor escreve a regra de negócio e encontra o resto resolvido. Hoje o Gluo roda o BoletimDeUrna.com, o site da ByJG (byjg.com.br) e o sistema de busca de CEP que fica nele.
A diferença em relação ao XMLNuke está por baixo. O Gluo cola componentes que continuam independentes, como o RestServer, o MicroOrm, o Serializer, o Migration e o Config. Cada um tem o seu repositório, os seus testes e o seu ciclo de versões, e pode ser usado sozinho em um projeto Laravel ou Symfony. A parte do framework que evolui fica em vendor/ e é atualizada com um composer update, enquanto o projeto gerado pode ser alterado à vontade.
Testar localmente com as minhas imagens
O projeto já vem com um docker-compose.yml, e um docker compose up -d sobe a API, o banco de dados e o frontend na minha máquina. Os contêineres são construídos a partir das imagens PHP ByJG, que existem nas variantes CLI, FPM, Nginx e Apache para cada versão do PHP. Eu não preciso instalar nada além do Docker.
Essas imagens nasceram de uma dor antiga: a cada troca de máquina eu reconfigurava PHP, extensões e ferramentas, e sempre faltava alguma coisa, além de precisar de várias versões do PHP ao mesmo tempo. Houve também o dia em que eu precisei do PHP 5.6 para um projeto antigo e as distribuições Linux já nem o traziam mais.
O shellscript.download vem da mesma dor. Com ele eu nem preciso ter o PHP instalado: um load.sh php-docker -- 8.4 cria na minha máquina um comando php que, por baixo, roda dentro do contêiner, e eu simplesmente entro no projeto e trabalho. Para ter outra versão ao lado basta repetir o comando com outro número. O Node funciona do mesmo jeito, e para Java e outras ferramentas há scripts que fazem a instalação com um comando. Contei os detalhes em Desenvolvimento PHP Fácil com Docker e VSCode.
Um ponto importante é o contrato OpenAPI, que eu escrevo uma única vez. O próprio código documenta cada endpoint, com atributos acima do método do controller. Um composer openapi extrai esses atributos para um arquivo openapi.json, e a partir daí o mesmo arquivo faz quatro trabalhos: o RestServer monta as rotas da API a partir dele, o Swagger UI serve as páginas de documentação em que dá para experimentar cada endpoint, o atributo #[ValidateRequest] valida o corpo de cada requisição antes de o método executar e devolve um erro 422 quando ele não segue o contrato, e o Swagger Test roda os testes de contrato, comparando cada resposta com o que foi declarado. Rota, documentação, validação e teste saem da mesma fonte, sem reescrever nem duplicar nada.
Publicar: CI/CD e DockNimbus
O mesmo pipeline que roda os testes constrói a imagem da aplicação. Para os pipelines eu mantenho o k8s-ci, uma imagem com as ferramentas necessárias para construir e publicar.
Faltava o lugar para onde publicar, e o DockNimbus surgiu dessa demanda. Ter VMs em uma nuvem é prático e muito rápido, principalmente em projetos grandes. Em projetos pequenos, porém, sai mais barato alugar um servidor dedicado pequeno, conectado à internet e não gerenciado, em que você recebe apenas a máquina. Toda vez eu tinha que configurar a rede, proteger o que ficaria exposto, instalar o Kubernetes e assim por diante, e quando havia mais de uma máquina a comunicação entre elas também passava pela internet.
O DockNimbus faz essa configuração por mim, com os padrões de segurança que eu aplicaria à mão. Ele transforma máquinas físicas e VMs, de um Raspberry Pi a um servidor x86, em uma plataforma com computação, armazenamento e clusters Docker Swarm e K3s, tudo declarado em um único manifesto, e liga as máquinas por uma malha WireGuard, de modo que o tráfego entre elas segue criptografado mesmo atravessando a internet. A documentação resume a diferença em relação ao Kubernetes assim: o Kubernetes responde "tenho um cluster, como orquestro contêineres nele?", e o DockNimbus responde "tenho máquinas, como transformo isso em uma plataforma?".
Ele funciona bem para instalações pequenas, que é o meu caso. Eu uso o DockNimbus para gerenciar o meu ambiente local e as minhas duas ASUS Spark GB10, e ele também faz o deploy em produção do site da ByJG, do BoletimDeUrna e do servidor MCP da documentação.
Produção: o mesmo Docker, com load balancer
A imagem que roda em produção é a mesma que eu testei localmente e que passou pelo CI, então não existe diferença entre ambientes para investigar quando algo dá errado.
Na frente das aplicações fica o EasyHAProxy. Eu gosto muito do HAProxy: ele é muito rápido e trabalha também na camada TCP, então pode ficar na frente de um MySQL, por exemplo, e não apenas de aplicações web. A configuração, porém, é bem complicada. Eu queria automatizá-la, e em 2018, quando comecei o projeto, a versão community do HAProxy não tinha nada parecido.
O EasyHAProxy gera essa configuração sozinho. Ele descobre os serviços pelas labels do Docker, pelos serviços do Swarm ou pelo Ingress do Kubernetes, emite os certificados TLS e recarrega o HAProxy sem derrubar conexões. O próprio DockNimbus usa o EasyHAProxy como load balancer.
Projetos independentes, centralizados por automação
Este é o ponto que o XMLNuke me ensinou pelo caminho mais difícil. Cada projeto tem o seu repositório, os seus testes e os seus releases, e nenhum depende de outro para ser publicado. O que faz deles um ecossistema é a automação.
Quando um projeto recebe um merge ou uma tag, a automação publica o que ele produz, sem nenhum passo manual, e a documentação, os charts e os pacotes vão todos para o mesmo site:
| O que é publicado | Como | Como você instala |
|---|---|---|
| Documentação | workflow reutilizável add-doc | opensource.byjg.com |
| Charts Helm | workflow reutilizável add-helm | helm repo add byjg https://opensource.byjg.com/helm |
| Pacotes DEB e RPM | workflow reutilizável add-pkg, assinados | apt install e dnf install |
| Fórmulas Homebrew | um workflow diário no tap acompanha as tags de release | brew install byjg/tap/<fórmula> |
| Imagens Docker | o build.yml de cada projeto | docker pull byjg/<imagem> |
| Componentes PHP | uma tag no Git | composer require byjg/<componente> |
O padrão é o mesmo em todos os projetos e está descrito nas Development Guidelines: nada é publicado antes de os testes passarem, releases são tags com versão semântica e o CI é escrito uma vez e chamado por cada projeto. As razões estão em Princípios Simples Para Não Complicar o Complexo.
Documentação para humanos e para a IA
A documentação mora no repositório de cada projeto, ao lado do código, e fala apenas daquele projeto. Quem documenta o MicroOrm escreve sobre o MicroOrm, sem precisar conhecer nem descrever o ecossistema. A documentação completa é gerada pela automação: a cada merge o conteúdo de cada projeto é copiado para o opensource.byjg.com, que monta o site inteiro, e o ByJG Docs MCP indexa o site com busca semântica e por palavra-chave. Qualquer assistente que fale MCP consulta esse índice e cita a página de onde tirou a resposta.
Com isso a documentação é escrita uma vez e passa a ter dois leitores. Um agente que precisa adicionar persistência a uma aplicação ByJG encontra o MicroOrm e a forma prevista de usá-lo, em vez de inventar uma camada de dados.
Com o XMLNuke eu aprendi que especificação e documentação importam. Hoje elas são também o contexto que a IA usa para trabalhar nos meus projetos, e cada mudança documentada melhora a próxima resposta.
O shell e o agente no mesmo lugar: Parolsh
O Parolsh nasceu de outro motivo. Eu prefiro trabalhar no shell na maior parte do tempo. Quando quero ver os logs de um pod, por exemplo, preciso primeiro listar os pods e depois rodar um kubectl logs para o primeiro, outro para o segundo, o terceiro, o quarto. O Claude Code e o Codex fazem esse tipo de investigação, mas neles tudo parte da linguagem natural e a interface toma conta do terminal, de modo que o trabalho acaba indo todo para a conversa e o shell vira coadjuvante.
No Parolsh as duas coisas convivem no mesmo prompt. Com !+kubectl get pods eu rodo o comando, vejo o resultado e ele já segue junto com a minha próxima pergunta. Aí eu peço os logs, pergunto por que os pods estão reiniciando (o que eu faria com um describe) e ainda posso pedir outras análises, o que acelera muito o processo. O Parolsh roda dentro do terminal de sempre, sem interface em tela cheia, e funciona com qualquer agente ACP, como Claude Code, Codex, Qwen Code e Gemini CLI.
O método, para quem quiser reproduzir
Nada disso depende das ferramentas ByJG. O que eu descrevi é o resultado de um método que serve para qualquer conjunto de projetos:
- Automatizar o que é repetitivo. Testes, builds, releases, pacotes e a publicação da documentação rodam no CI.
- Centralizar o que é compartilhado. Um conjunto de workflows, um site de documentação, um conjunto de imagens base.
- Isolar o que é independente. Cada componente tem repositório, testes e ciclo de versões próprios, e só a automação os une.
- Usar o mesmo contêiner em todos os ambientes. Desenvolvimento, CI e produção rodam a mesma imagem.
- Escrever a documentação uma vez, para dois leitores. Cada projeto documenta a si mesmo, e a automação monta a documentação completa. Uma pessoa lê no site e um assistente de IA lê pelo MCP.
Do index.asp até aqui
O que eu queria em 2000 com um index.asp e meia dúzia de includes é o que eu continuo querendo: que o desenvolvedor escreva o que a página faz e encontre o resto resolvido. O que mudou foi o tamanho do "resto", que hoje inclui o ambiente local, o pipeline, a plataforma, o load balancer, os pacotes e a documentação que a IA consulta.
Cada projeto continua funcionando sozinho, e ninguém precisa adotar tudo. Para começar por uma API, veja o Gluo. Para colocar HTTPS na frente dos seus serviços, o EasyHAProxy. Para transformar máquinas em plataforma, o DockNimbus. Para dar contexto ao seu assistente de IA, o ByJG Docs MCP. O mapa completo está em O Ecossistema ByJG.